
22. September 2026
Vom Export zum Wochenbericht: ein n8n-Ablauf im Detail (Teil 2/2)
Inhalt
- Der Auftrag und der eigentliche Plan
- Die Architektur in drei Bausteinen
- Ablauf A: das Format einmal lernen
- Warum das Modell nichts ausführt
- Die Prüfung ist der eigentliche Trick
- Ablauf B: der Wochenlauf
- Das Dashboard ist kein Code
- Unter der Haube: Sehen, was tatsächlich passiert
- Fehler: Was schiefging
- Was davon übertragbar ist
- Grenzen und offene Punkte
- Fazit
- Links
Im ersten Teil ging es um die Frage, auf welche Technik KI-gestützte Abläufe überhaupt gestellt werden können, und darum, dass der Modellaufruf der kürzeste Teil der Arbeit ist. Das ist einfach zu behaupten, solange es niemand überprüft. Hier beschreibe ich einen Aufbau, den ich genau so gebaut habe, mit allen Entscheidungen, und mit den Stellen, an denen ich Fehler gemacht habe.
Der Aufbau ist dreiteilig: n8n steuert die Abläufe, Grist ist Datenbank und Dashboard gleichzeitig, und ein lokal laufendes Sprachmodell via Ollama übernimmt zwei genau umrissene Aufgaben. Es gibt weder selbstgeschriebenen Dashboard-Code, noch externen Modellaufruf und an keiner Stelle KI-generierten Code, den ein Modell geschrieben hat und der anschließend ausgeführt wird. Der letzte Punkt klingt eigentlich selbstverständlich, ist es aber nicht. Dazu später mehr.
Der Auftrag und der eigentliche Plan
Der Wunsch auf dem dieses Projekt basiert, lautete ursprünglich ungefähr: „Ein Dashboard, das mir mit KI meine Wochenzahlen zeigt.". Das ist eine völlig normale Formulierung, die aber gleich zwei Fallen enthält. Die erste ist, dass „mit KI" nichts über den Nutzen aussagt, der mit KI erzeugt werden soll, sondern nur über die gewünschte Technik. Die zweite ist, dass „meine Wochenzahlen" ungenau definiert ist, und genau das ist die Metrik and der sich das Ergebnis am Ende messen muss.
Die Arbeit besteht deshalb zuerst darin, den Auftrag zu zerlegen, und insbesondere die eigentliche Intention zu klären. Übrig bleiben zwei Stellen, an denen ein Sprachmodell tatsächlich Arbeit abnimmt, statt sie nur interessanter aussehen zu lassen, oder schlicht Rechenleistung zu verschwenden:
- Das Lernen des Dateiformats: Der Export aus dem Vorsystem kommt als CSV mit deutschen Spaltenüberschriften, deutschen Zahlenformaten und deutschen Statuswörtern, und das Modell schlägt einmalig vor, welche Rohspalte auf welches Zielfeld geht. Hier ist insbesondere geschickt, dass das Eingabe-Dateiformat dabei relativ felxibel behandelt werden kann. Der "lernende" Intake der Dateien ist somit resilient gegen geänderte Dateiformate (bis zu einem gewissen Punkt). Bei einem stark formalisierten oder gut definiterten Dateiformat lässt sich auch hier der KI-Anteil einsparen!
- Das Schreiben des Wochenberichts: Aus den aggregierten Zahlen entsteht der Fließtext, der oben im Dashboard steht.
Alles andere ist kein KI-Problem. Die Diagramme, die Filter, die Kennzahlen, die Rechteverwaltung und die Einstellungsmaske: Hier kann mit überdachter Softwarewahl viel Arbeit gespart werden. Wir erinnern uns an die Build-vs.-Buy-Entscheidung und die damit verbundene teure Wartung. In diesem Fall nutze ich Grist, eine Verbindung aus Tabellenkalkulation, Datenbank und "Widgets" (frei erstellbaren, interaktiven Diagrammen), was außerdem diese Funktionen schon von Haus aus mitbringt. Grist bietet noch aber viel mehr, und wird Subjekt eines zukünftigen Blogposts sein.
Diese Aufteilung hat einen angenehmen Nebeneffekt. Die Demo wird in zwei unabhängige Hälften zerlegbar. „Grist ist ein guter Ort für diese Daten (und ersetzt Eigenentwicklung)" lässt sich ganz ohne KI zeigen. „Die KI nimmt echte Arbeit ab" lässt sich getrennt davon hervorheben. Wenn eine Hälfte nicht die Kundenerwartung trifft, reißt sie die andere nicht mit. Ein Dashboard, das nur beeindruckt, wenn das Modell sich benimmt, ist ein Spiel mit dem Feuer: Eine schlechte Generierung im falschen Moment und der Demo-Termin ist durch.
Die Architektur in drei Bausteinen
Es lohnt sich, die Aufgabenteilung einmal explizit darzustellen, weil sie die eigentliche Entwurfsentscheidung ist.
| Baustein | Aufgabe | Was es ausdrücklich nicht tut |
|---|---|---|
| n8n | Orchestrierung: Auslöser, Datei einlesen, Zuordnung anwenden, Grist-API aufrufen, protokollieren | keine Darstellung, keine Datenhaltung |
| Grist | Persistenz und Visualisierung: Datenhaltung, Aggregation per SQL, Diagramme, Filter, Rechte | keine Ablauflogik |
| Ollama (lokal) | KI-Kern: Zuordnung vorschlagen, Wochenbericht formulieren | kein Zugriff in den Datenpfad |
Der dritte Punkt in der letzten Zeile ist die harte Regel und Kern des ganzen Aufbaus: Zwischen der Rohdatei und der Zahl im Dashboard steht kein Modellaufruf. Das Modell hat einmalig, vorab und unter menschlicher Aufsicht, ein Datenmodell vorgeschlagen. Der wöchentliche Lauf wendet diese Zuordnung deterministisch an. Wer dieselbe Datei zweimal durchschickt, bekommt zweimal dasselbe Ergebnis, immer. Dadurch wird eine der größten Schwächen von Sprachmodellen umgangen, der Nondeterminismus.
Ablauf A: das Format einmal lernen
Der erste Ablauf wird von Hand gestartet und läuft einmal pro Dateiformat, nicht einmal pro Datei. Er liest die Rohdatei, ermittelt das Trennzeichen, zieht die Kopfzeile und drei Beispielzeilen heraus und schickt diese an das KI-Modell für einen Vorschlag für das Schema.
Zurück diese Schema als JSON-Objekt, das sagt, welche Rohspalte auf welches Zielfeld geht und wie sie zu lesen ist:
{
  "source_label": "German sales export",
  "columns": {
    "Date":     { "from": "Transaktionsdatum", "parse": "date", "dayfirst": true },
    "Category": { "from": "Produktkategorie", "parse": "text" },
    "Value":    { "from": "Betrag (EUR)", "parse": "number",
                  "decimal": ",", "thousands": "." },
    "Status":   { "from": "Bearbeitungsstatus", "parse": "choice",
                  "map": { "abgeschlossen": "Abgeschlossen",
                           "offen": "Offen",
                           "storniert": "Storniert" } }
  },
  "notes": "Mixed ISO and DD.MM.YYYY dates in the same column."
}
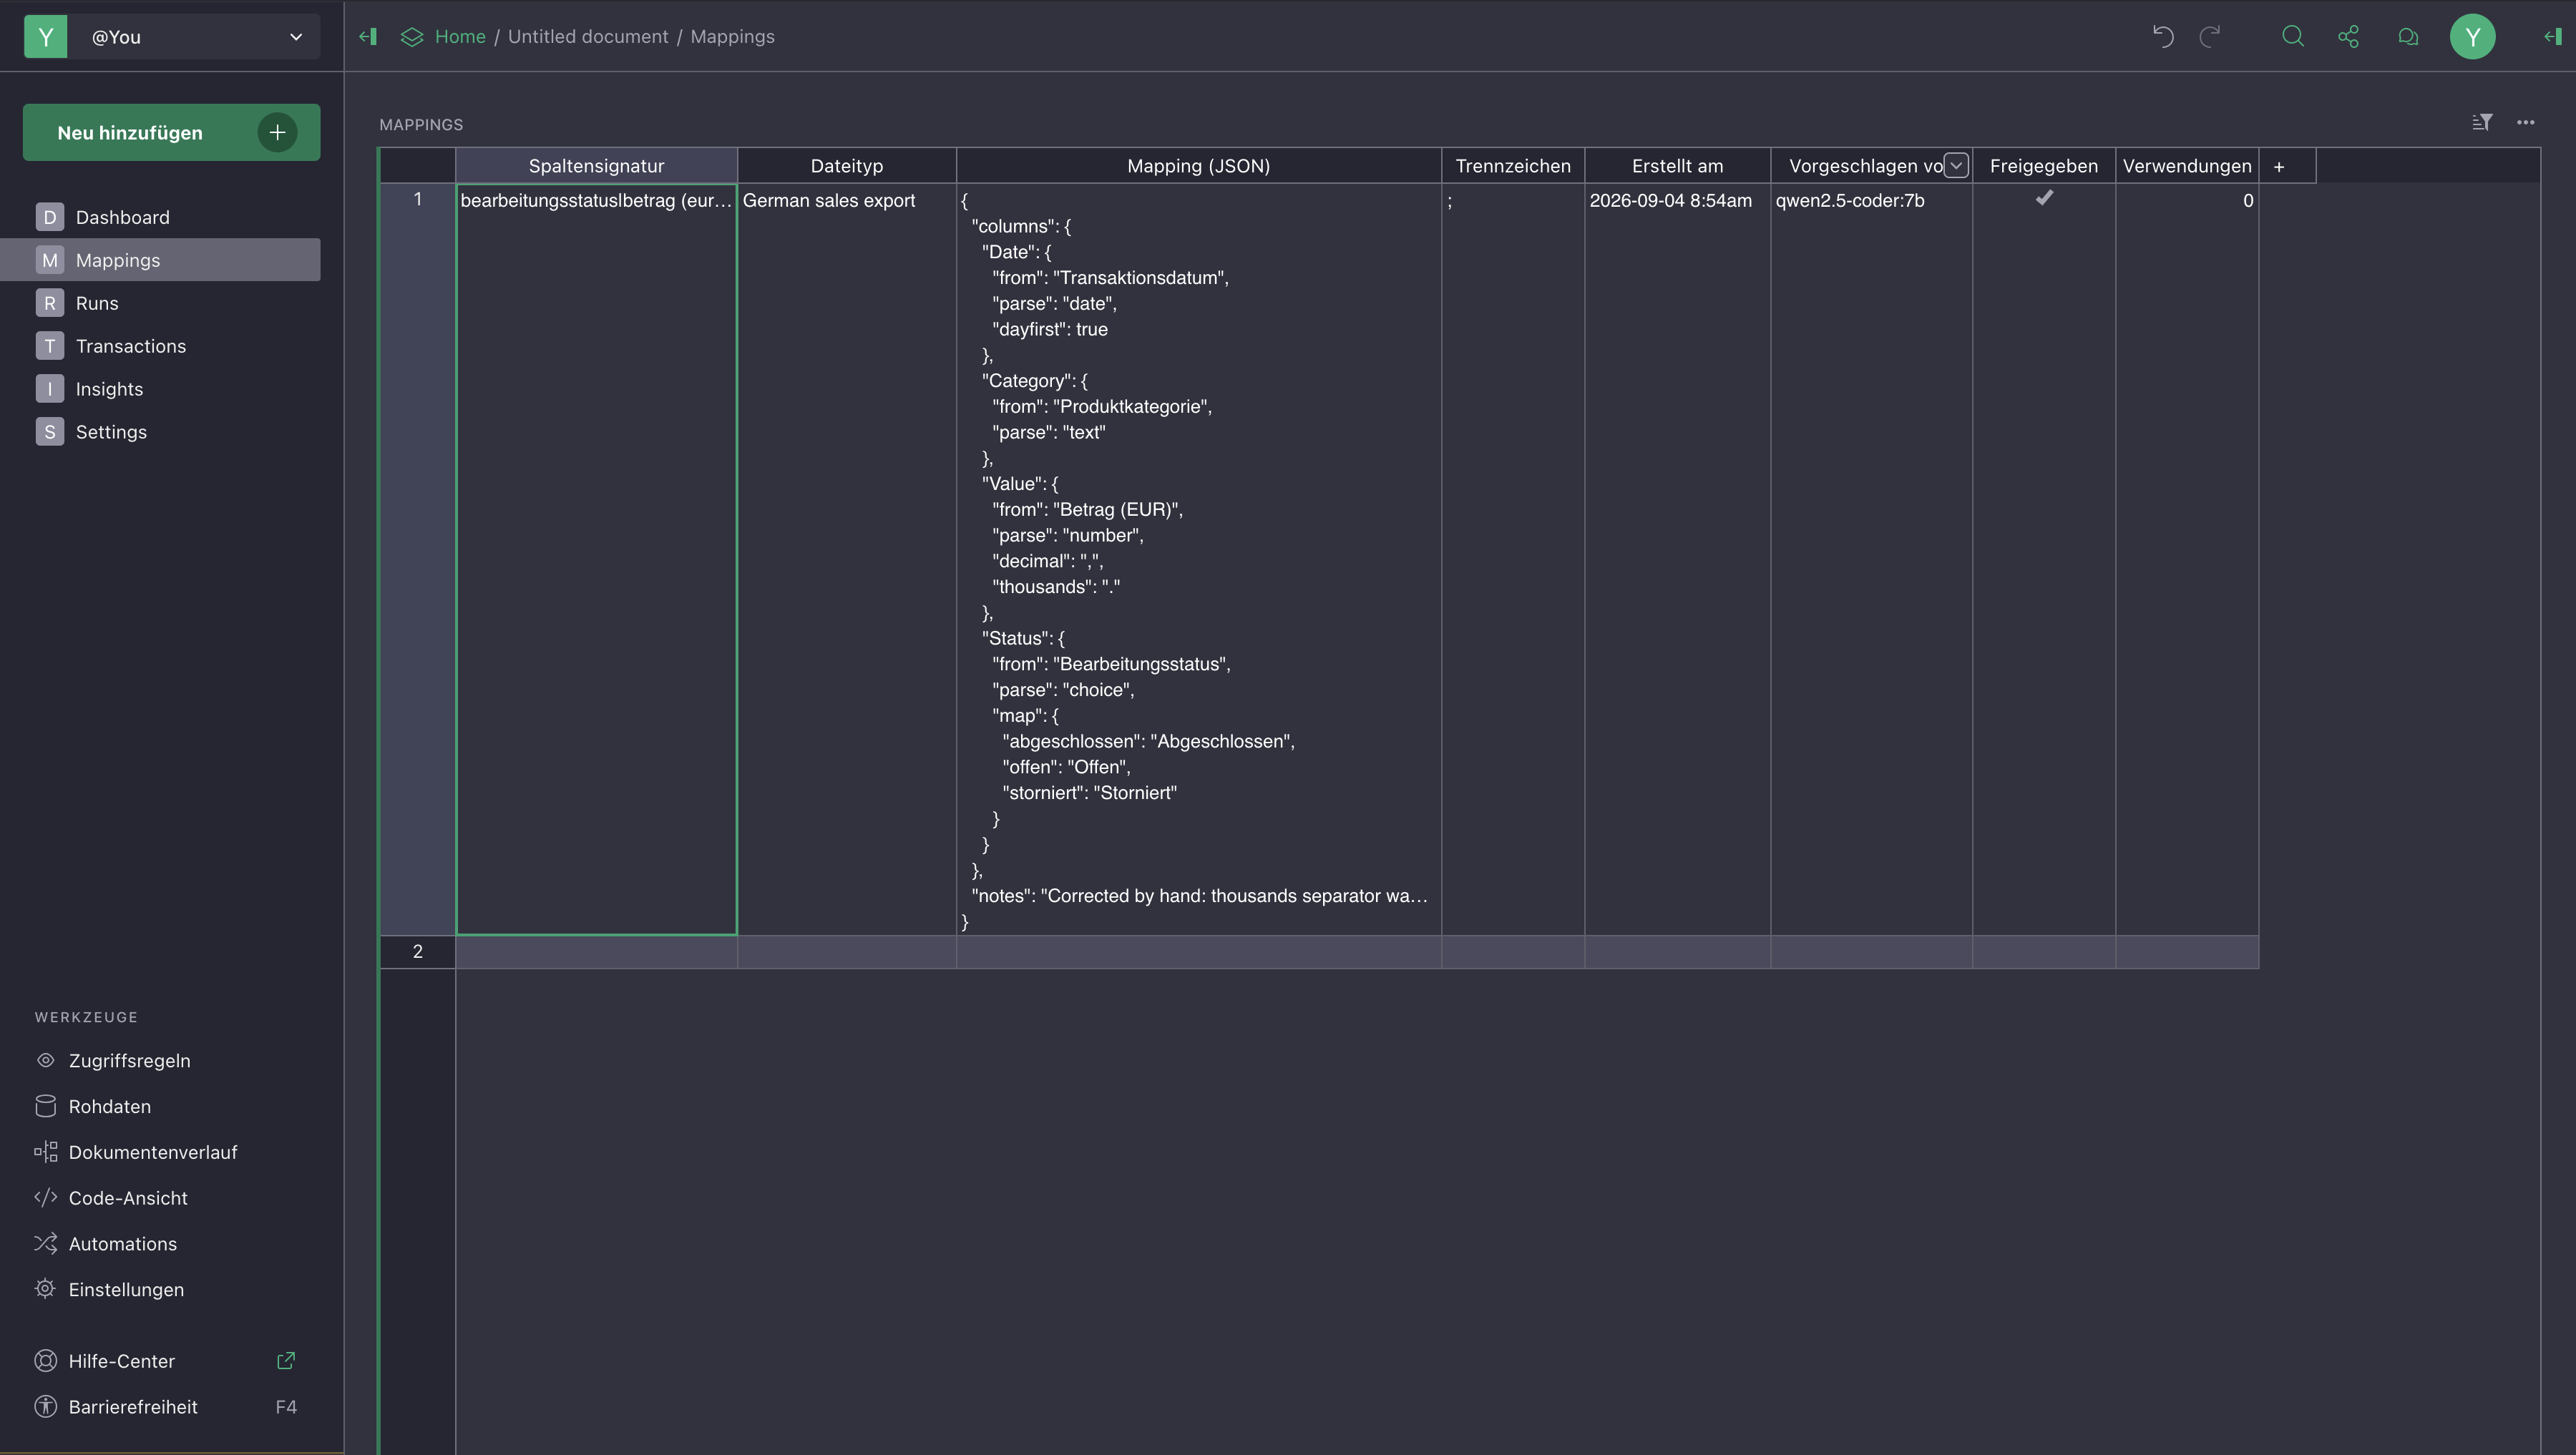
Der Vorschlag landet nicht direkt im Betrieb, sondern in einer Tabelle Mappings in Grist, zusammen mit dem Modellnamen, dem Zeitpunkt und einem Feld Freigegeben. Ein Nutzer liest den Vorschlag und erteilt die Freigabe. Diese manuelle Handlung fällt einmal pro Berichtsformat an.
Der Schlüssel, unter dem eine Zuordnung abgelegt wird, ist die Signatur der Datei: die Spaltennamen, kleingeschrieben, alphabetisch sortiert und aneinandergehängt. Das Sortieren ist wichtig, falls bspw. beim nächsten Export zwei Spalten vertauscht werden, ist es für den Ablauf immer noch dasselbe Format, und die gelernte Zuordnung passt weiterhin. Mit dieser einen Zeile Code kann damit noch einmal einiges an Arbeit gespart werden.
Warum das Modell nichts ausführt
Die erste Fassung dieses Aufbaus sah etwas anders aus: Das Modell schreibt ein kleines Python-Skript, welches die Datei umformt, und dieses Skript wird bei jedem Lauf ausgeführt. Das funktioniert, und ist aber trotzdem der Punkt, an dem ich den ersten Entwurf weggeworfen habe.
Der Grund ist nicht in erster Linie Sicherheit, obwohl das auch zählt: Ein Prozess, der von einem Sprachmodell erzeugten Code ausführt, ist einer, dessen Rechte man ab sofort sehr genau begründen muss. Der Aufwand dafür wächst schneller als der Nutzen. Der wichtigere Grund ist Prüfbarkeit: KI-generierter Code lässt sich nicht sinnvoll gegen eine Liste erlaubter Einsatzarten prüfen; er lässt sich nur lesen (von jemandem, der Python kann). Eine Beschreibung wie oben lässt sich dagegen Feld für Feld prüfen, ohne dass sie ausgeführt werden muss.
Die praktische Ausbeute dieser Umstellung ist daneben auch sehr groß: Rund siebenhundert Zeilen Python und ein eigener Container sind ersatzlos entfallen. Die Anzahl der Schritte in n8n ist zwar in Summe sogar gestiegen, von vierzehn auf vierundzwanzig über beide Abläufe, das ist aber kein Rückschritt. Die benannten Schritte in einem n8n-Diagramm sind viel einfacher zu- und einzuordnen als eine Funktion in einer Datei, die unter Umständen (wie viele "magische" Excel-Tabellen) in Schichten institutioneller Unordnung verschwindet.
Die Prüfung ist der eigentliche Trick
Dass nichts ausgeführt wird, heißt aber noch lange nicht, dass es auch richtig ist. Eine Zuordnung kann tadellos aufgebaut und trotzdem falsch sein. Das ist der gefährlichere Fall, weil er keinen Fehler auslöst, aber gleichzeitig still falsche Zahlen produziert.
Das klassische Beispiel steht direkt in den (synthetischen) Quelldaten des Projekts. Ein Betrag 1.240,50 ist deutsch formatiert: Ein Komma als Dezimalzeichen und ein Punkt als Tausendertrennzeichen. Schlägt das Modell stattdessen "thousands": "" vor, wird daraus beim Einlesen keine Fehlermeldung, sondern die Zahl 1,24 oder gar keine. Je nach Lesart, und nicht vorhersehbar - Stichwort Determinismus! Das Dashboard zeigt dann Summen an, die um drei Größenordnungen danebenliegen, ohne einen Fehler zu erkennen.
Der Prüfschritt macht deshalb zwei Dinge hintereinander. Zuerst prüft er die Form gegen eine geschlossene Menge:
- Jeder Verweis auf eine Rohspalte muss eine Spalte sein, die in dieser Datei tatsächlich existiert.
- Jeder Parser muss einer von vier bekannten sein.
- Jeder Status muss auf genau einen der drei erlaubten Werte zeigen.
- Alle vier Zielspalten müssen vorhanden sein.
Danach wird die Zuordnung probeweise auf die echten Zeilen der Datei angewendet, ohne etwas zu speichern. Kommen dabei weniger als neunzig Prozent der nicht-leeren Beträge als gültige Zahl heraus, wird der Vorschlag abgelehnt, mit dem ersten misslungenen Wert im Klartext in der Fehlermeldung:
Value spec parses only 3/29 non-empty rows (e.g. "1.240,50").
Check "decimal"/"thousands".
Dasselbe gilt für die Datumsspalte, und für den Status gilt eine strengere Regel: Jeder in der Datei vorkommende Statuswert muss abgedeckt sein. Ein einziger vergessener Wert bedeutet sonst, dass eine ganze Kategorie von Zeilen im Dashboard fehlt, ohne dass der Missstand aufgezeigt wird.
Das ist der wichtigste Punkt, den ich aus dem Projekt mitnehme: Bei einem KI-Sprachmodell im Prozessablauf ist nicht primär die Frage, ob es Unsinn produziert, sondern ob der Unsinn an einer Stelle auffällt, die jemand kontrolliert. Eine strukturelle Prüfung fängt hier das Offensichtliche, aber ohne einen genau kontrollierten Probelauf wird es später teuer.
Ablauf B: der Wochenlauf
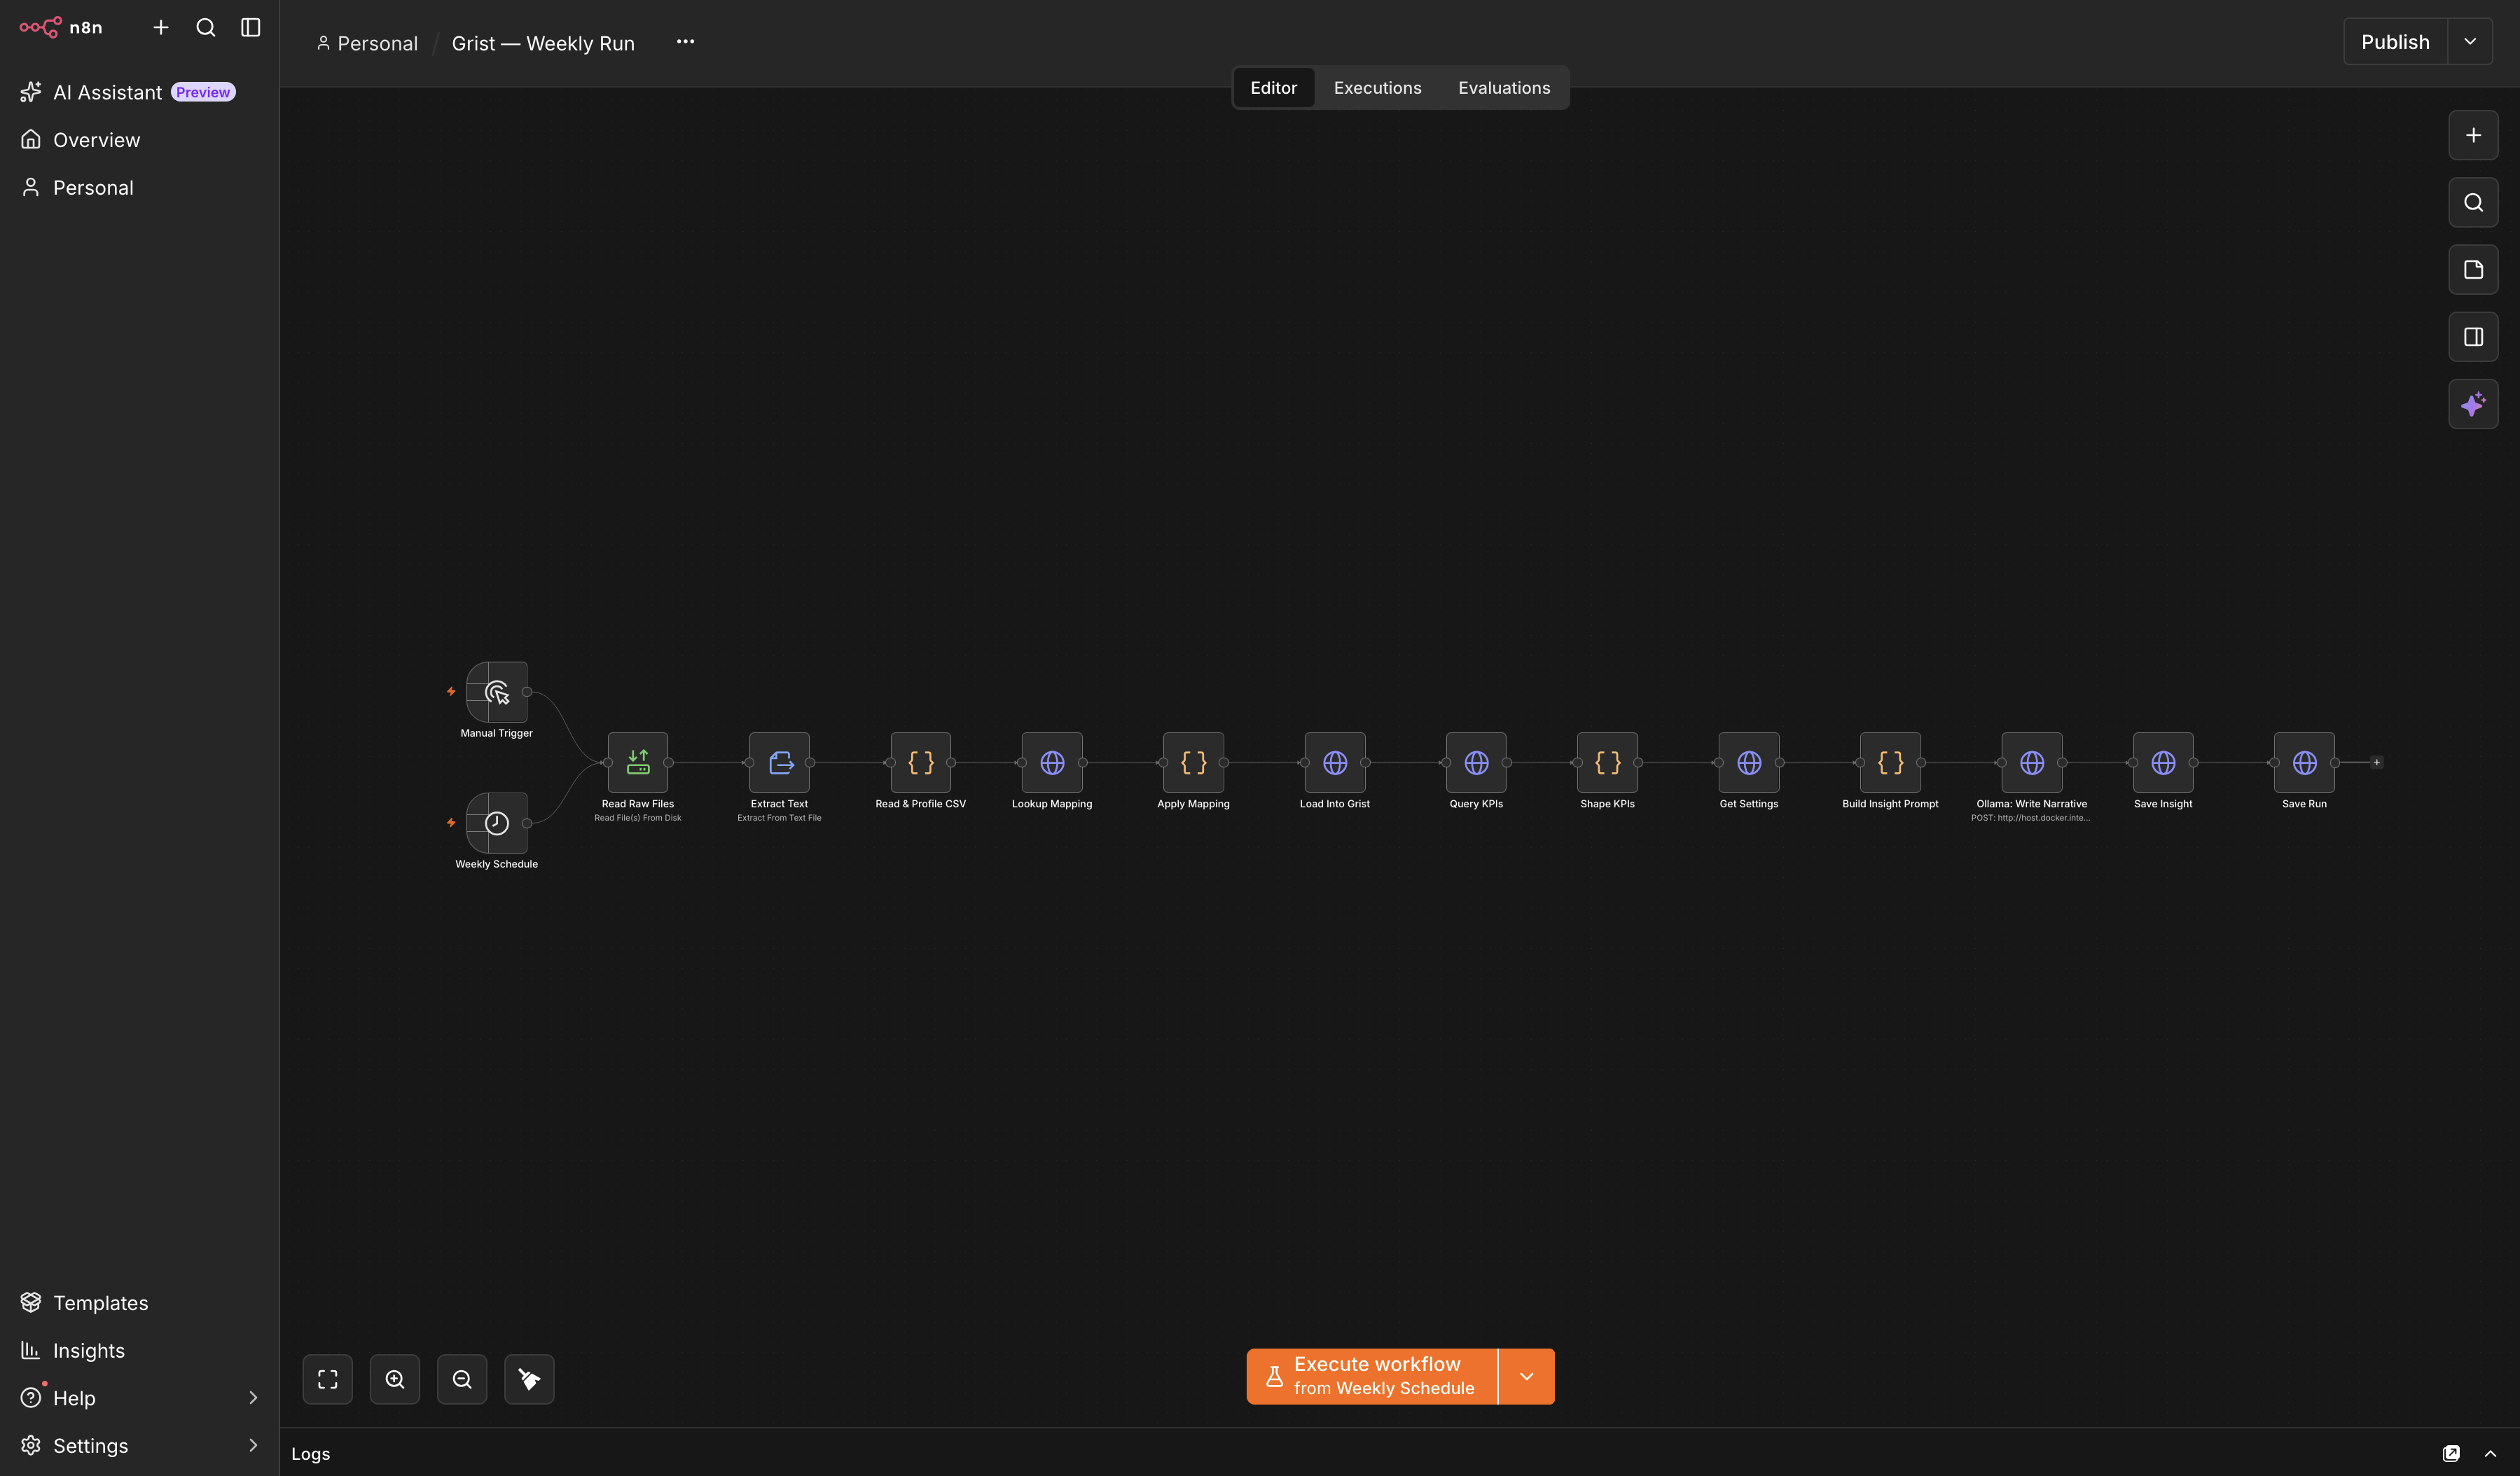
Der zweite Ablauf hat fünfzehn Schritte, er hängt an einem Zeitplan und läuft automatisch:
- Einlesen der neueste Datei und Ermitteln ihrer Signatur
- Suchen der passenden gespeicherte Zuordnung und Anwendung auf die Datei
- Schreiben der Zeilen nach Grist
- Aggregierung der Zahlen
- Schreiben des Berichts und Ablage nach Grist
- Protokollierung des Laufs
Zwei Details daran sind übertragbar.
Wenn keine Zuordnung passt, wird abgebrochen. Die Fehlermeldung nennt den Dateinamen, die Signatur und den nächsten Schritt:
No mapping is stored for "export_2026-09.csv" (signature: …).
Run the "Grist — Learn Mapping" workflow once for this file shape,
check the result in the Mappings table, then re-run this workflow.
Ein Ablauf, der sauber stoppt und klare Fehler meldet, ist in der Praxis am meisten wert. Die Überlegung ist dieselbe wie der Freigabeschritt aus Ablauf A.
Die Aggregation macht die Datenbank, nicht der Ablauf. Grist stellt eine SQL-Schnittstelle bereit, und Wochentrend, Kategorien- und Statusverteilung können in einer einzigen Abfrage über UNION ALL aggregiert werden. Das ersetzt ein eigenes Aggregationsskript vollständig und hat den Nebeneffekt, dass die Zahlen im Bericht und die Zahlen in den Diagrammen immer gleich sind, denn sie stammen aus derselben Tabelle und werden auf demselben Weg berechnet.
KI-Einsatz ganz minimal
Erst nach diesem Schritt kommt das KI-Modell zum Einsatz, und zwar mit einem sehr eng definierten Auftrag: Es bekommt die fertig gerechneten Kennzahlen als JSON und schreibt drei bis fünf Sätze Fließtext plus eine kurze Aufzählung, als "Management-Info". Im Prompt steht dabei ausdrücklich, dass ausschließlich die übergebenen Zahlen verwendet werden dürfen. Ein Feld Schwerpunkt aus den Einstellungen steuert Gewichtung und Tonfall des resultierenden Textes, ebenfalls mit der Einschränkung: Betonung darf geändert werden, die Zahlen niemals.
Gespeichert wird zusammen mit dem Bericht das JSON-Objekt, das das Modell gesehen hat. Hier liegt ein wichtiges Detail: Jede Zahl im Text lässt sich prüfbar auf das zurückführen, was dem Modell vorlag.
Das Dashboard ist kein Code
Die Darstellung entsteht vollständig in der Grist-Oberfläche. Das war eine bewusste Entscheidung, mit einer Einschränkung.
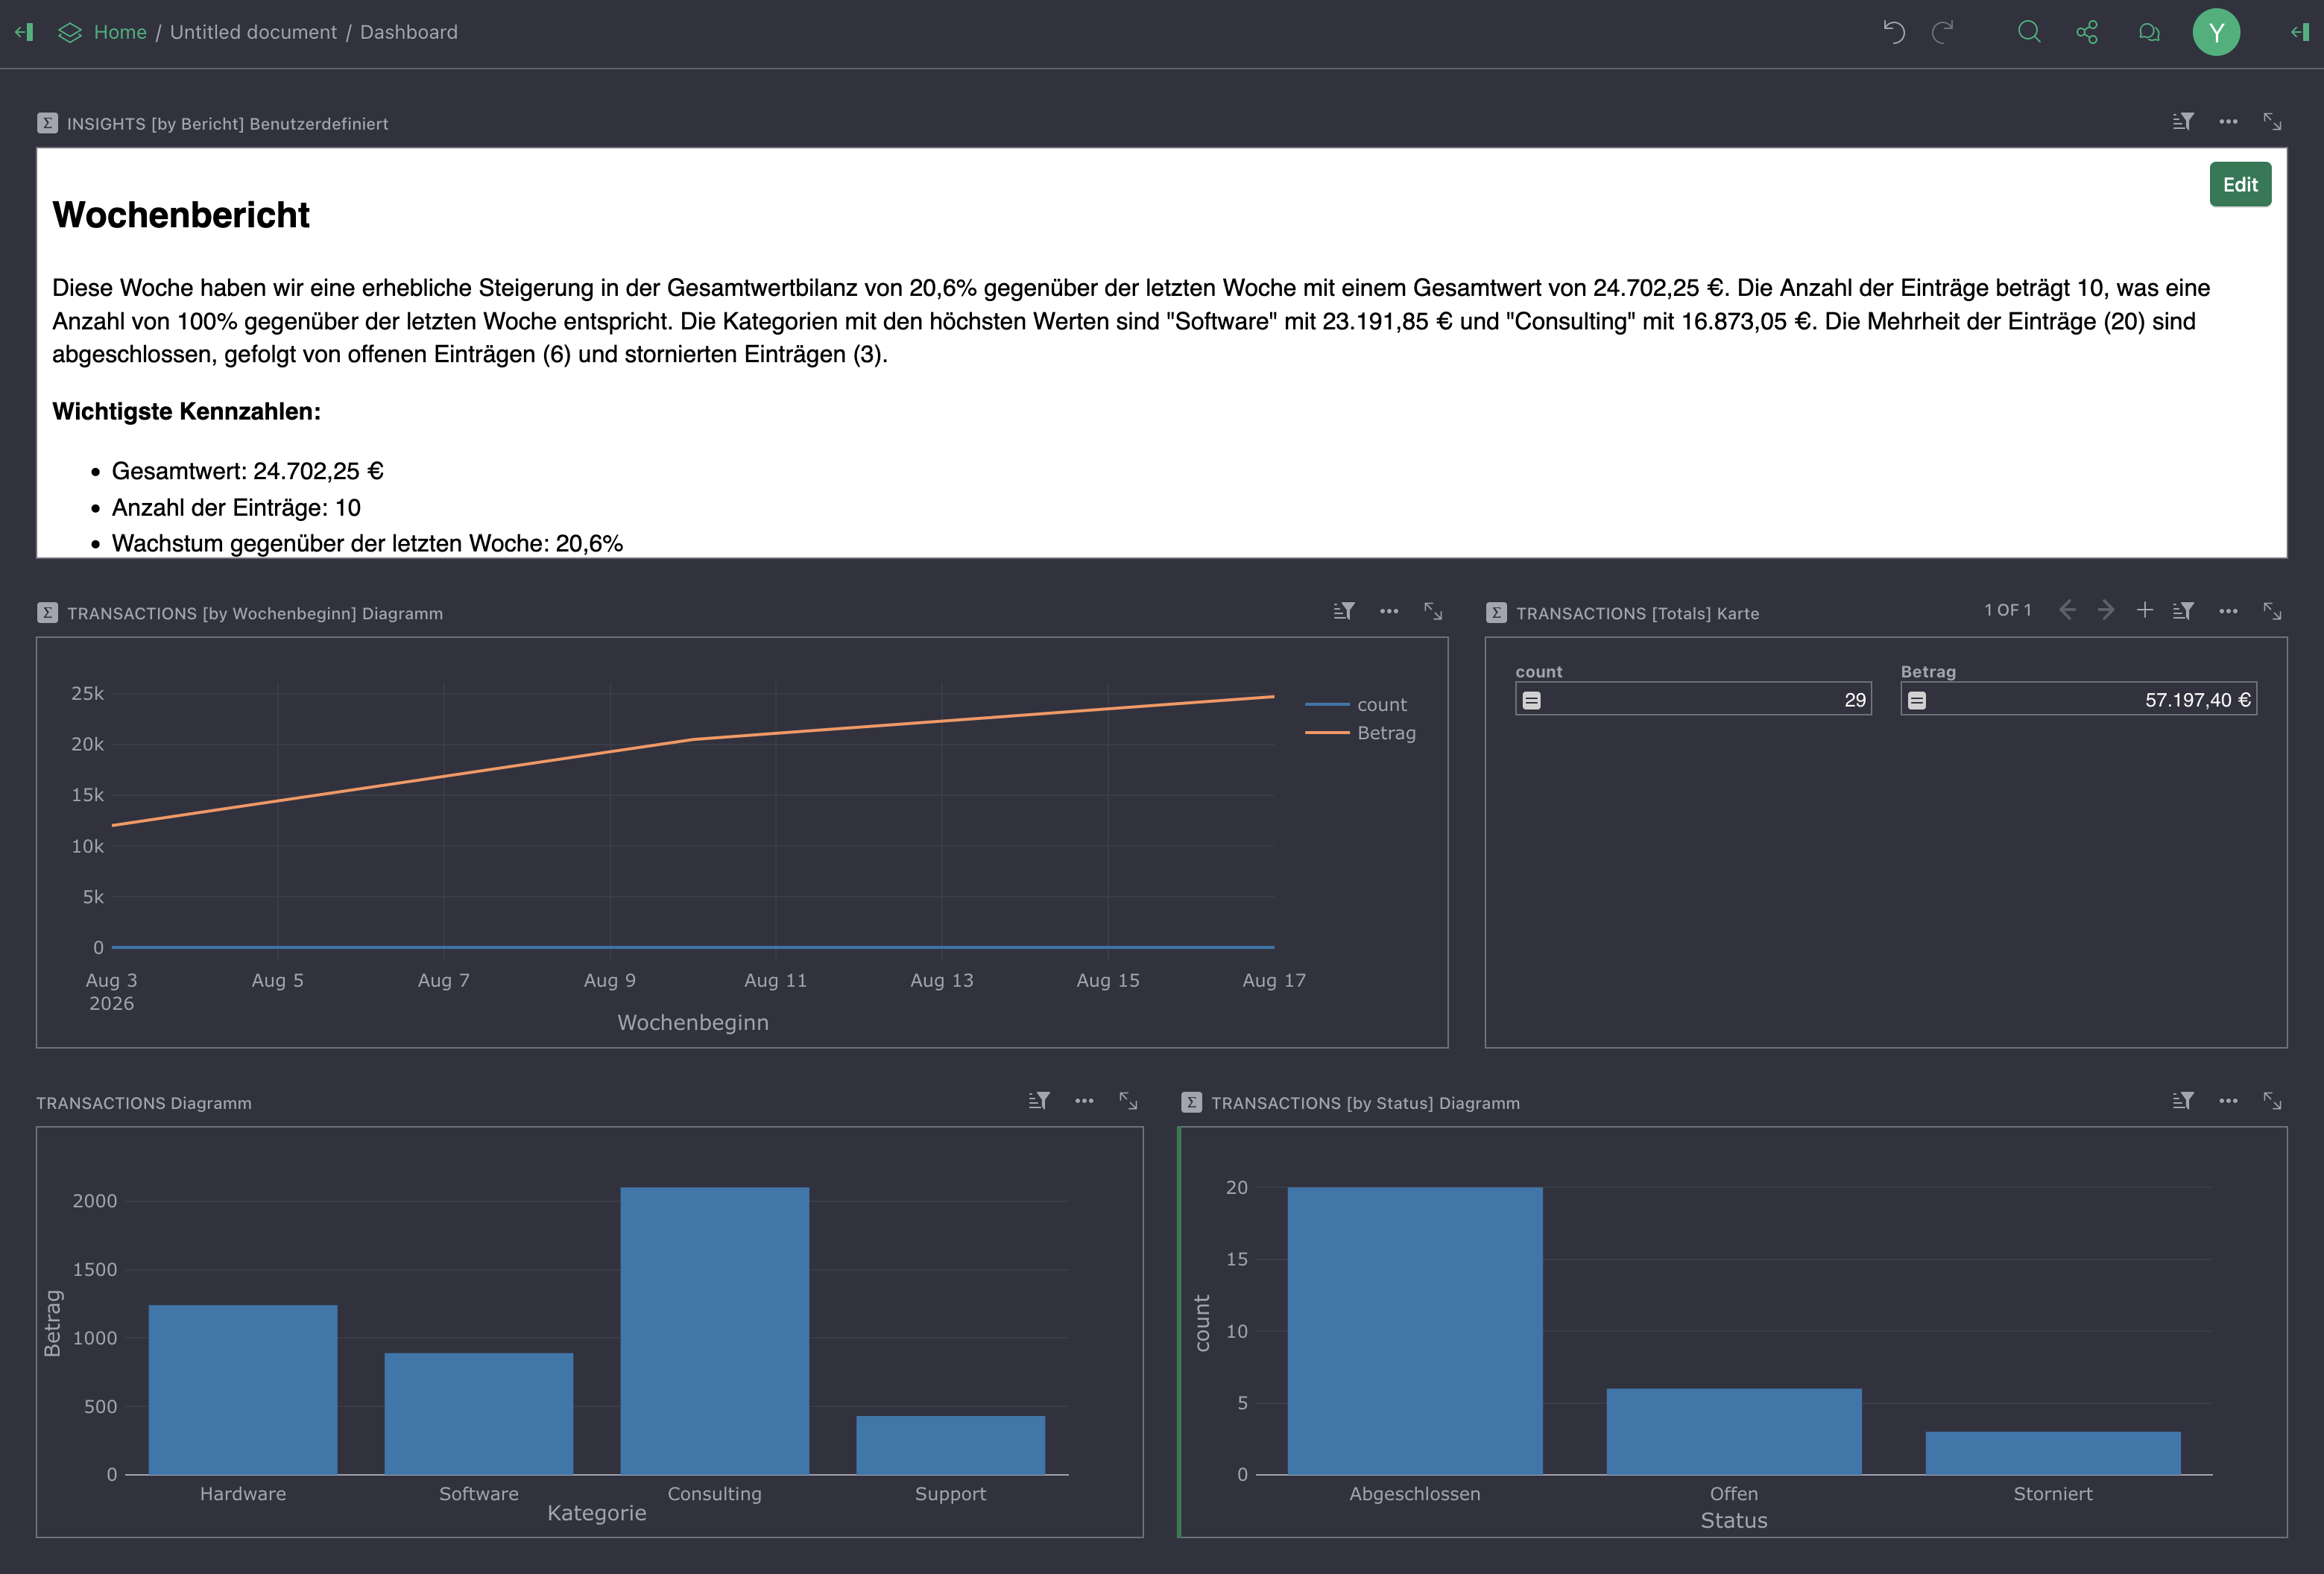
Die Einschränkung: Grist hat kein eingebautes Kennzahlen-Widget, also keine Möglichkeit, eine große Zahl mit Beschriftung auf der Oberfläche darzustellen. Ein (Um)weg dorthin ist eine Summentabelle, die nach nichts gruppiert und anschließend vom Typ "Tabelle" auf Typ "Karte" umgestellt wird. Das ergibt eine einzeilige Zusammenfassung mit beschrifteten Feldern und sieht schlichter aus als eine selbstgebaute Kachelreihe. Ein entsprechendes Widget lässt sich auch selbst erstellen, mindert dabei aber den Standardisierungsgrad.
Der Gegenwert: Der Kunde kann beispielsweise ein Diagramm an eine andere Stelle ziehen, einen Filter ändern oder eine Spalte hinzufügen, ohne weitere Hilfe oder einen Entwicklungsauftrag. Das Urteil, ob das ein Mehrwert ist, bleibt jedem selbst überlassen. Bei einer selbstgebauten Oberfläche ist jede dieser Änderungen ein Vorgang mit Terminabstimmung. Bei einer Eigenentwicklung sind das größere Posten, und dahinter steht derselbe Gedanke wie beim Plattformargument aus dem ersten Teil.
Eine Kleinigkeit mit unverhältnismäßiger Wirkung: Der Wochentrend gruppiert nicht auf das Datum, sondern auf eine Formelspalte Wochenbeginn, die den Montag der jeweiligen Woche ausrechnet. Gruppiert man auf das reine Datum, ergibt das einen Punkt pro Tag und daraus eine nichtssagende Linie. Die Spalte Wochenbeginn existiert ausschließlich zu diesem Zweck.
Unter der Haube: Sehen, was tatsächlich passiert
Es gibt eine dritte Dashboard-Seite, die im ursprünglichen Entwurf nicht vorgesehen war, die ich aber jetzt in jedem ähnlichen Aufbau anlege. Sie heißt „Unter der Haube" und zeigt drei Tabellen: die Läufe, die gelernten Zuordnungen und die Einstellungen.
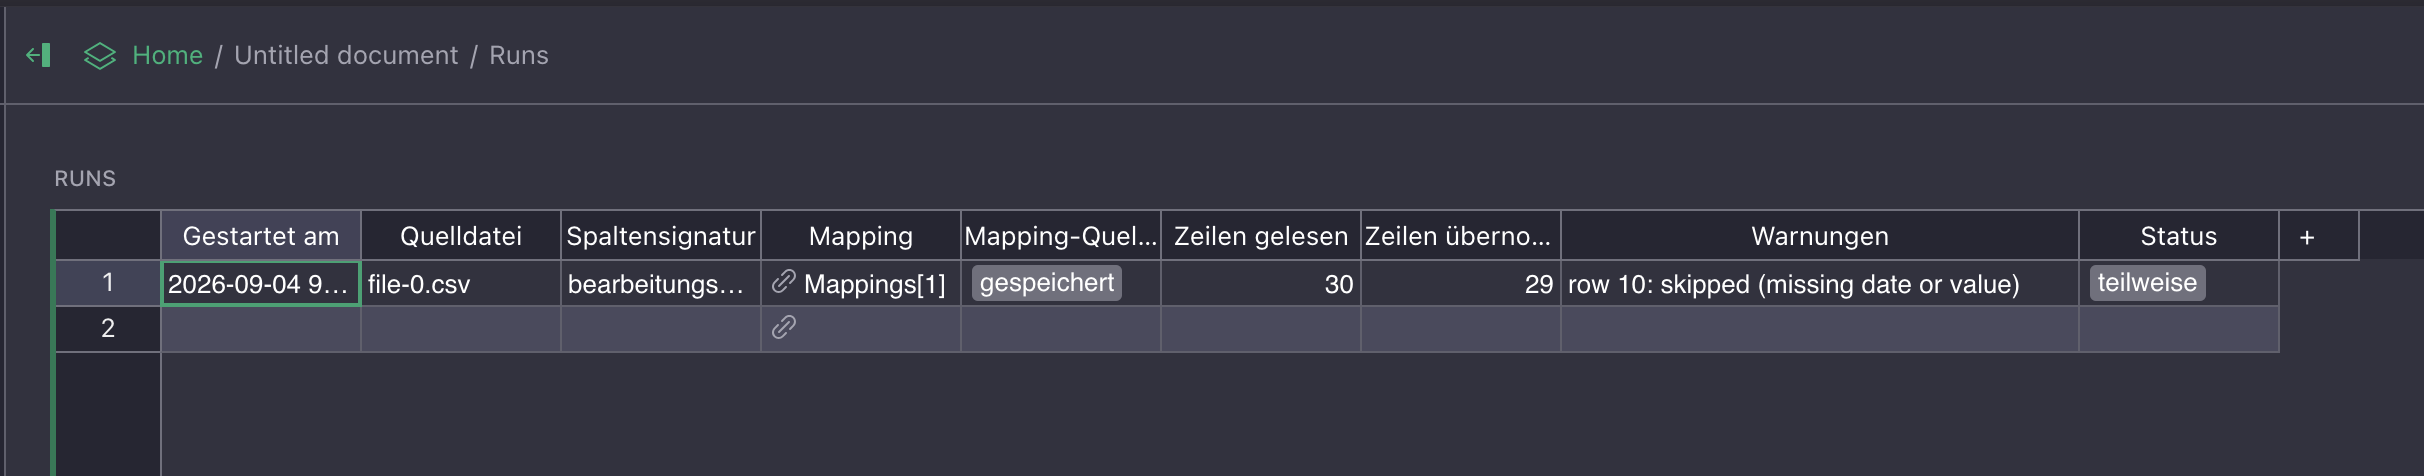
Die Lauftabelle protokolliert pro Durchlauf die Quelldatei, die verwendete Zuordnung, die Anzahl eingelesener und geschriebener Zeilen, den Status und (wichtig!) die Warnungen, agiert also als Protokollseite. Jede Zeile, die nicht verarbeitet werden konnte, steht dort mit Zeilennummer und dem Grund, bzw. der Meldung. In den Beispieldaten dieses Projekts gibt es eine Zeile mit leerem Betrag. Die frühere Fassung der Verarbeitung hat sie stillschweigend verworfen, jetzt steht auf der Protokollseite: Zeile 11 übersprungen, kein Betrag.
Die Tabelle mit den Zuordnungen zeigt daneben, was das KI-Modell vorgeschlagen hat und ob eine Freigabe vorliegt. Zusammen macht das aus dem Aufbau einen prüfbaren Ablauf statt eine Blackbox. Es ist auch die Seite, an der mir ein fehlerhafter Vorschlag zuerst aufgefallen ist, der zwei Drittel der Zeilen verschluckt hatte: Die Zahl „RowsOut" stand sichtbar neben „RowsIn" und hat damit den Fehler sichtbar gemacht.
Wer das Thema Nachvollziehbarkeit aus Sicht der EU-KI-Verordnung betrachtet: Genau das ist die praktische Form von menschlicher Aufsicht und Protokollierung. Eine Absichtserklärung im Konzept ist deutlich schwächer als eine nachvollziehbare Protokollierung, die die menschliche Aufsicht eindeutig nachweist.
Fehler: Was schiefging
Aus der Umsetzung habe ich vier lehrreiche Fehler mitgenommen:
Das Zahlenformat. Der schon beschriebene Fall mit Dezimal- und Tausendertrennzeichen ist genau deshalb im Prompt mit drei ausgeschriebenen Beispielen explizit beschrieben und wird zusätzlich im Probelauf geprüft. Warum? Ein Hinweis im Prompt ist eine Bitte und keine Garantie. Eine Garantie muss deshalb außerhalb des KI-Aufrufs zugesichert werden.
Der Doppellauf. Der Schreib-Schritt hängt Zeilen an, statt sie abzugleichen. Läuft der Wochenlauf zweimal über dieselbe Datei, stehen alle Zahlen doppelt im Dashboard. Für eine Machbarkeitsstudie ist das vertretbar, für den unbeaufsichtigten Betrieb nicht. Die Lösung ist einfach: Ein Schlüssel aus Quelldatei und Zeilennummer, der beim Schreiben abgeglichen statt angehängt wird.
Das kleine Modell. Für das Lernen des Formats reicht ein 7-Mrd-Parameter-Modell auf einem Laptop gut aus, denn die Aufgabe ist eng und die schematische Prüfung fängt Ausrutscher. Beim Fließtext wird die geringe Größe dagegen deutlich: Der Bericht ist korrekt und liest sich flach. Das ist der Preis dafür, dass die KI lokal läuft, aber hier kann nachgestellt werden. Dieser eine Schritt läuft einmal pro Woche und darf langsam sein, also kann dort bspw. ein deutlich größeres lokales Modell stehen, ohne dass es im Alltag stört, je nach Kapazität.
Die Umgebung. Ein banaler, aber typischer Zeitfresser: Der Container erreichte das lokale Modell nicht, weil Ollama in der Standardeinstellung nur lokal "zuhört". Ebenso war die Grist-Konfiguration auf macOS nicht direkt startfähig. Beides sind aber Fußnoten, können aber gut Zeit kosten. Bei „läuft lokal" steckt der Aufwand entsprechend selten im Modell.
Was davon übertragbar ist
Der konkrete Anwendungsfall ist austauschbar, während das Muster dahinter allgemeingültig ist:
Die KI an den Rand, nicht in die Mitte. Das KI-Modell interpretiert einmalig unstrukturierte Daten und formuliert am Ende menschlich lesbar. Dazwischen liegt statischer Code, der jedes Mal dasselbe Ergebnis liefert.
Beschreibungen liefern lassen, keine Anweisungen. Was ein Modell ausgibt, sollten Daten sein, die gegen eine geschlossene Liste geprüft werden können und kein Code, der unbeaufsichtigt ausgeführt wird.
Prüfen gegen die echten Daten, nicht nur gegen die Form. Der Probelauf gegen die Datei, für die die Zuordnung geschrieben wurde, hat in diesem Projekt am meisten Fehler gefangen, auch neben strukturellen Prüfungen.
Protokollierung zahlt sich aus Mit der Protokollseite lassen sich die geforderten Prüfungen viel einfacher durchführen, und andere Nachfragen sind auch schneller bedient.
Grenzen und offene Punkte
Bei diesem Aufbau handelt es sich um eine Machbarkeitsstudie mit einem klar begrenzten Anspruch, und es wäre anmaßend, das als fertiges Produkt zu beschreiben. Die fehlende Absicherung gegen Doppelläufe wurde erwähnt, und dazu kommt, dass das Zielschema aus vier Spalten besteht, weil echten Daten des Kunden zum Zeitpunkt des Entwurfs noch nicht vorlagen. Außerdem besteht die Frage, ob die Exporte überhaupt unsauber genug sind, um die Lösung mit KI-generiertem Schema zu rechtfertigen. Das ist die wichtigste offene Frage des ganzen Vorhabens. Ist der Export schon sauber, löst die gelernte Zuordnung ein nicht existentes Problem, und der Aufwand gehört in den Bericht und in das Dashboard.
Auch die Ausbaustufe von Grist muss geklärt sein, bevor etwas produktiv geht: Die quelloffene Variante unter Apache-2.0-Lizenz ist kostenlos, bringt aber keine Anbindung an das betriebseigene Anmeldeverfahren und keine Audit-Protokolle mit. Beides ist Teil der kostenpflichtigen Version. Das ist die gleiche Rechnung wie bei den n8n-Editionen aus dem ersten Teil und sollte aus demselben Grund früh aufgemacht werden.
Und schließlich: Ein Aufbau wie dieser rechtfertigt sich über Wiederholung. Ein Bericht pro Woche, zweiundfünfzig Mal im Jahr, plus die entfallende Handarbeit beim nächsten neuen Exportformat schafft echten Wert. Bei einem Bericht pro Quartal wäre die ehrliche Empfehlung, ihn weiter von Hand zu schreiben.
Fazit
Im ersten Teil dieser Serie haben wir sichtbar gemacht, dass der Aufruf und damit die Nutzung eines KI-Modells nur einer von vielen Schritten ist, wenn ein Prozess "mit KI" versehen wird. Praktisch ausgearbeitet und belegt haben wir es in diesem Beitrag: Von vierundzwanzig Schritten über zwei Abläufe in n8n enthalten nur zwei einen Modellaufruf, und keiner der beiden liegt zwischen den Eingabedaten und dem tatsächlichen Erkenntnisgewinn, dem Dashboard.
Was das Projekt an Arbeit spart, ist trotzdem echt. Keine manuelle zuordnung von Exportspalten mehr, und niemand muss montags schnell eine Zusammenfassung abtippen. Es ist aber wichtig zu verstehen, dass der Gewinn eben nicht im Modell liegt (das ist klein und "schwach", und läuft sogar lokal), sondern in dem Gerüst darum herum. Genau dieses Gerüst bringt eine Automatisierungsplattform mit, und die Umsetzung ist geradlinig, wenn das Problem genau verstanden wird.
Links
- Teil 1: n8n: Eine (KI-)Automatisierungs-Plattform statt Infrastruktur im Eigenbau
- n8n: https://n8n.io/
- Grist: https://www.getgrist.com/
- Grist-SQL-Schnittstelle: https://support.getgrist.com/api/
- Ollama: https://ollama.com/
Passende Leistung
Individuelle KI-Umsetzung
Klassische Einzelberatung und Use-Case-Entwicklung: von der Prozessanalyse über den sicheren Piloten bis zum Regelbetrieb.
Mehr erfahren